ระบบที่แข็งแรงต้องรู้ว่าจะปกป้องอะไร รับแรงกระแทกได้อย่างไร ใช้ AI และเทคโนโลยีอย่างรับผิดชอบ และออกแบบร่วมกับคนที่ต้องอยู่กับระบบนั้นทุกวัน
โรงงานแห่งหนึ่งส่งมอบสินค้าได้ตรงเวลาแทบทุกเดือน ผู้บริหารจึงเชื่อว่าระบบมีประสิทธิภาพสูง
แต่เมื่อมองลึกลงไป ความตรงเวลานั้นเกิดจากหัวหน้างานคนเดิมที่คอยอยู่แก้ปัญหาหลังเลิกงาน พนักงานบางคนต้องทำ OT เป็นประจำ ช่างผู้เชี่ยวชาญถูกโทรตามทุกครั้งที่เครื่องจักรมีอาการผิดปกติ และเมื่อแผนเปลี่ยน ทุกคนต้องช่วยกันฝืนให้ผ่านวันนั้นไปก่อน
ผลลัพธ์ภายนอกดูดี
แต่ระบบกำลังใช้ความเหนื่อย ความเสียสละ และความสามารถเฉพาะตัวของคนบางกลุ่มเป็นกันชน โดยไม่เคยนับต้นทุนเหล่านั้นในรายงาน
ระบบเช่นนี้อาจมีประสิทธิภาพในวันที่ทุกอย่างปกติ แต่ไม่ได้แข็งแรงจริง เพราะเมื่อคนสำคัญไม่อยู่ ความต้องการเปลี่ยนมากขึ้น หรือเกิดเหตุขัดข้องหลายเรื่องพร้อมกัน ระบบจะเริ่มล้มเหลวทันที
ประสิทธิภาพอย่างเดียวไม่พอ เมื่อโลกจริงไม่เคยนิ่ง
องค์กรจำนวนมากถูกออกแบบให้ใช้ทรัพยากรได้คุ้มค่าที่สุดในสภาวะปกติ ใช้คนเต็มกำลัง เครื่องจักรเต็มตาราง สต็อกต่ำ และลดเวลาว่างให้เหลือน้อยที่สุด
แนวทางนี้อาจทำให้ต้นทุนบางตัวดูดี แต่เมื่อระบบไม่มีพื้นที่รับความผันแปร งานด่วน การหยุดเครื่อง หรือการเปลี่ยนแผนเล็กน้อย ก็สามารถลุกลามเป็นปัญหาใหญ่ได้
ระบบที่แข็งแรงต้องมีความยืดหยุ่นของระบบ (resilience) คือความสามารถในการรับแรงกระแทก รักษาสิ่งที่สำคัญ ฟื้นตัวจากความผิดปกติ และเรียนรู้จนรับมือได้ดีขึ้นในครั้งต่อไป
Resilience ไม่ได้แปลว่าต้องสำรองทุกอย่าง หรือสร้างต้นทุนเผื่อไว้โดยไม่มีขอบเขต มันเริ่มจากการเลือกให้ชัดว่า อะไรคือสิ่งที่องค์กรยอมให้หยุดไม่ได้
อาจเป็นการส่งมอบสินค้าหลักให้ลูกค้าสำคัญ การรักษาคุณภาพและความปลอดภัยของผลิตภัณฑ์ การทำให้ข้อมูลสำคัญเข้าถึงได้ หรือการมีคนที่ทดแทนงานสำคัญกันได้
เมื่อรู้ว่าสิ่งใดต้องปกป้อง องค์กรจึงสามารถเลือกได้ว่าควรมี Buffer ตรงไหน ควรมีทางเลือกใด และความเสี่ยงใดที่ยอมรับได้หรือยอมรับไม่ได้
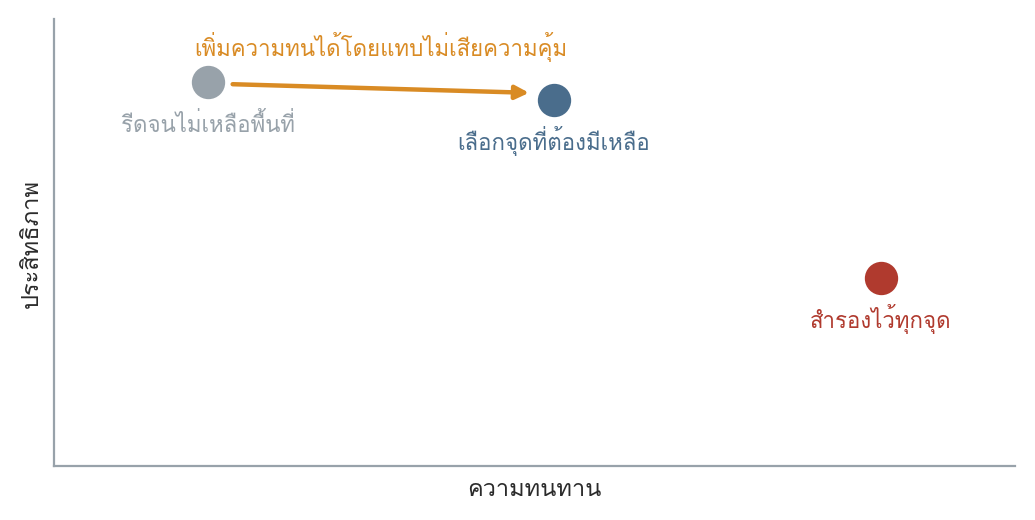
EXHIBIT 20.1 · ประสิทธิภาพกับความทนทานเป็นสองแกน
ที่มา: Efficiency และ Resilience ไม่ได้อยู่บนเส้นเดียวกัน
รูปที่ 94 — ตำแหน่งสามแบบบนสองแกนเดียวกัน
- Resilience คืออะไร — ความสามารถในการรับแรงกระแทก ฟื้นตัว และเรียนรู้จนกลับมาทำงานได้ดีขึ้น
- ไม่ต้องมีเหลือทุกจุด — แต่ต้องรู้ว่าจุดใดสำคัญ ต้องมีทางเลือกอะไร และใครตัดสินใจเมื่อเกิดเรื่อง
- สิ่งที่ต้องยอมรับ — ถ้าไม่เลือกตำแหน่งบนแกนนี้ ระบบจะไหลไปอยู่มุมที่ไม่เหลืออะไรเอง
ให้ดูอะไร ช่วงระหว่างจุดเทากับจุดน้ำเงิน เพิ่มความทนได้โดยแทบไม่เสียความคุ้ม
อ่านผิดบ่อย อ่านว่าต้องเลือกอย่างใดอย่างหนึ่ง ทั้งที่มีช่วงที่ได้ทั้งสองอย่าง
อย่าเริ่มจากรายการความเสี่ยงที่ยาวเกินไป
หลายองค์กรเริ่มเรื่องความเสี่ยงด้วยการทำรายการทุกสิ่งที่อาจผิดพลาด รายการจึงยาวขึ้นทุกปี แต่คนในระบบยังไม่รู้ว่าควรปกป้องอะไรก่อนเมื่อเกิดเหตุจริง
สิ่งที่สำคัญกว่าการรวบรวมความเสี่ยงทั้งหมด คือการระบุความสามารถสำคัญ (critical capability) ที่องค์กรต้องรักษาไว้ ไม่ว่าจะเกิดอะไรขึ้น
ตัวอย่างเช่น หากธุรกิจต้องส่งมอบสินค้าเฉพาะกลุ่มให้ลูกค้ารายสำคัญภายในเวลาที่กำหนด ความสามารถสำคัญอาจไม่ใช่การให้ทุกเครื่องจักรทำงานเต็มประสิทธิภาพ แต่อาจเป็นการรักษาเครื่องจักรหรือเครื่องมือที่ผลิตสินค้านั้นได้ การมีวัตถุดิบสำรองที่เหมาะสม การมีผู้ปฏิบัติงานทดแทนได้ และการมีทางเลือกเมื่อแผนเดิมใช้ไม่ได้
การคิดเช่นนี้ทำให้ความเสี่ยงไม่ใช่เพียงรายการที่ต้องรายงาน แต่กลายเป็นคำถามออกแบบระบบว่า ความสามารถใดกำลังเปราะบาง และเราจะปกป้องมันอย่างไร
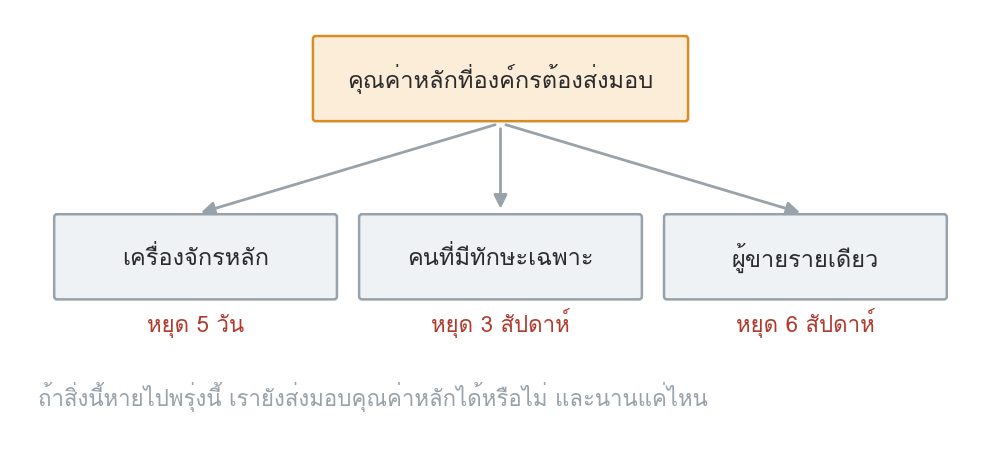
EXHIBIT 20.2 · Critical Capability
ที่มา: เริ่มจากสิ่งที่ต้องไม่เสีย ไม่ใช่จากรายการความเสี่ยง
รูปที่ 95 — ไล่จากคุณค่าหลักลงมาหาสิ่งที่มันพึ่งอยู่
- อาจเป็นอะไรได้บ้าง — เครื่องจักรหนึ่งตัว คนที่มีทักษะเฉพาะ ระบบข้อมูล หรือผู้ขายรายเดียว
- คำถามที่ใช้คัด — ถ้าสิ่งนี้หายไปพรุ่งนี้ เรายังส่งมอบคุณค่าหลักได้หรือไม่ และนานแค่ไหน
- ใช้ต่ออย่างไร — ออกแบบการป้องกัน การสำรอง และแผนฟื้นตัวเฉพาะรายการที่เหลืออยู่
ให้ดูอะไร บรรทัดสีแดงใต้แต่ละกล่อง บอกว่าถ้าสิ่งนั้นหายไป ระบบหยุดไปนานแค่ไหน
อ่านผิดบ่อย คิดว่ายิ่งระบุความเสี่ยงได้มากยิ่งปลอดภัย ทั้งที่มันทำให้ลำดับความสำคัญหายไป
จุดเดียวที่หยุดทั้งระบบ ต้องถูกมองเห็นก่อน
ทุกระบบมีจุดล้มเหลวเพียงจุดเดียว (single point of failure) คือส่วนที่หากหยุดหรือใช้ไม่ได้แล้ว ทำให้ความสามารถสำคัญของทั้งระบบหยุดตามไปด้วย
อาจเป็นเครื่องจักรเฉพาะทาง คนที่มีความรู้เพียงคนเดียว ระบบข้อมูลที่ไม่มีทางเลือก ซัพพลายเออร์รายเดียว หรือขั้นตอนอนุมัติที่ต้องผ่านบุคคลเดียว
จุดเหล่านี้มักถูกมองข้ามในวันที่ทุกอย่างทำงานปกติ เพราะมันไม่สร้างปัญหาจนกว่าจะหยุดจริง
การมองเห็น single point of failure ไม่ได้หมายความว่าต้องทำสำรองทุกอย่างทันที แต่ต้องทำให้ความเสี่ยงมองเห็น และเลือกวิธีลดผลกระทบตามความสำคัญ
บางเรื่องแก้ได้ด้วยการฝึกคนให้ทดแทนกัน บางเรื่องต้องมีอะไหล่สำคัญหรือแผนบำรุงรักษา บางเรื่องต้องมีซัพพลายเออร์ทางเลือก และบางเรื่องต้องเปลี่ยนกติกาการตัดสินใจไม่ให้ทุกอย่างค้างอยู่กับคนเพียงคนเดียว
สิ่งที่อันตรายที่สุดไม่ใช่การมีจุดอ่อน แต่คือการไม่รู้ว่าจุดอ่อนนั้นอยู่ตรงไหน
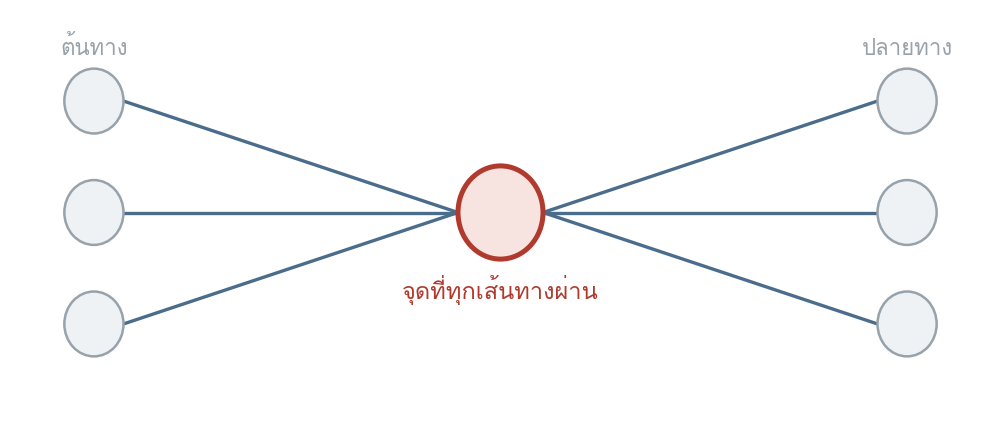
EXHIBIT 20.3 · Single Point of Failure
ที่มา: จุดเดียวที่หากล้มเหลวแล้ว ระบบส่วนใหญ่หยุดตาม
รูปที่ 96 — เส้นทางทั้งหมดที่ผ่านจุดเดียวกัน
- วิธีหา — ไล่ถามทีละจุดว่าถ้าจุดนี้หยุดวันนี้ อะไรเดินต่อไม่ได้บ้าง
- ที่มักถูกมองข้าม — คนที่รู้เรื่องหนึ่งอยู่คนเดียว และรหัสผ่านหรือสิทธิ์ที่อยู่กับคนเดียว
- ทางลดความเสี่ยง — อะไหล่สำคัญ คนทดแทน เอกสารวิธีทำงานที่เข้าถึงได้ และผู้ขายสำรอง
ให้ดูอะไร ถ้าเอาวงกลมสีแดงออก ไม่มีเส้นใดเดินต่อได้เลย
อ่านผิดบ่อย คิดว่าเรื่องนี้เป็นงานของฝ่ายความเสี่ยง ทั้งที่คนที่รู้จริงคือคนหน้างาน
การปรับตัวไม่ใช่การเปลี่ยนแผนทุกวัน
การปรับตัว (adaptation) คือความสามารถในการเปลี่ยนวิธีทำงานเมื่อเงื่อนไขเปลี่ยน โดยยังรักษาสิ่งที่สำคัญของระบบไว้
องค์กรที่เปลี่ยนแผนทุกวันไม่จำเป็นต้องปรับตัวเก่ง บางครั้งกำลังเพียงตอบสนองต่อแรงกดดันล่าสุด โดยไม่มีหลักว่าอะไรควรเปลี่ยน อะไรควรคงไว้ และผลกระทบจะตกกับใคร
การปรับตัวที่ดีต้องมีสามสิ่ง
อย่างแรก คือสัญญาณที่ทำให้เห็นว่าแผนเดิมเริ่มใช้ไม่ได้ เช่น งานค้างเพิ่มขึ้นผิดปกติ กำลังการผลิตลดลง ความต้องการเปลี่ยนเกินขอบเขต หรือความเสี่ยงต่อคุณภาพสูงขึ้น
อย่างที่สอง คือทางเลือกที่เตรียมไว้ล่วงหน้า เช่น การสลับกำลังคน การใช้เครื่องจักรหรือซัพพลายเออร์สำรอง การเปลี่ยนลำดับผลิตภายใต้กติกาที่ตกลงไว้ หรือการลดกิจกรรมที่ไม่สำคัญเพื่อปกป้องงานหลัก
อย่างที่สาม คือสิทธิ์ตัดสินใจที่ชัด เมื่อเกิดเหตุใด ใครปรับอะไรได้ และเรื่องใดต้องยกระดับ
หากไม่มีสามสิ่งนี้ การเปลี่ยนแผนจะกลายเป็นการดับไฟ ไม่ใช่ adaptation
ความยืดหยุ่นต้องวัดได้ ไม่ใช่รู้สึกเอาเอง
องค์กรอาจบอกว่าตนผ่านวิกฤตมาได้ จึงเชื่อว่าระบบยืดหยุ่น แต่การผ่านเหตุการณ์หนึ่งครั้งอาจเกิดจากความทุ่มเทของคน หรือการแก้ปัญหาเฉพาะหน้าที่ทำซ้ำไม่ได้
Resilience ที่วัดได้ควรช่วยตอบคำถามว่า
-
ระบบตรวจพบความผิดปกติได้เร็วเพียงใด
-
หลังเหตุขัดข้อง ระบบใช้เวลานานเท่าไรจึงกลับมาส่งมอบได้
-
งานหรือบริการสำคัญใดหยุดไม่ได้ และมีทางเลือกใดรองรับ
-
คน เครื่องจักร ข้อมูล และซัพพลายเออร์ทดแทนกันได้มากเพียงใด
-
หลังเหตุการณ์ ระบบเปลี่ยนอะไรเพื่อลดความเปราะบางในครั้งต่อไป
ตัวเลขเหล่านี้ไม่จำเป็นต้องมาก แต่ต้องเชื่อมกับความสามารถสำคัญที่องค์กรเลือกจะปกป้องจริง
AI และเทคโนโลยีต้องเพิ่มความสามารถของคน ไม่ใช่ขยายความเปราะบางของระบบ
AI และระบบอัตโนมัติช่วยคาดการณ์ ตรวจจับความผิดปกติ วางแผน และลดงานซ้ำได้มาก
แต่หากข้อมูลต้นทางไม่ดี กติกาการตัดสินใจไม่ชัด หรือไม่มีคนที่เข้าใจวิธีตรวจสอบและโต้แย้งข้อเสนอของระบบ เทคโนโลยีอาจทำให้ความผิดพลาดเดิมเกิดเร็วขึ้น ในขนาดที่ใหญ่ขึ้น
การใช้เทคโนโลยีอย่างรับผิดชอบ (AI governance) จึงต้องเริ่มจากการถามว่า
ระบบกำลังตัดสินใจเรื่องใดข้อมูลใดเป็นฐานของการตัดสินใจ และข้อมูลนั้นเชื่อถือได้หรือไม่เมื่อคำแนะนำของระบบผิด ใครจะเห็นก่อน ใครมีสิทธิ์หยุด และใครรับผิดชอบต่อผลที่เกิดขึ้นคนหน้างานสามารถเข้าใจข้อเสนอของระบบ และใช้วิจารณญาณของตนเองได้หรือไม่
AI ที่ดีไม่ควรทำให้คนเลิกคิด แต่มันควรทำให้คนเห็นสัญญาณเร็วขึ้น เห็นทางเลือกมากขึ้น และใช้เวลามากขึ้นกับการตัดสินใจที่ต้องอาศัยความรับผิดชอบของมนุษย์
ระบบใหม่ต้องผ่านคนที่ต้องอยู่กับมันทุกวัน
องค์กรอาจออกแบบระบบใหม่ได้ดีบนกระดาษ แต่หากไม่เข้าใจว่าคนหน้างานต้องใช้มันอย่างไร ระบบนั้นมักสร้างภาระรูปแบบใหม่ขึ้นมา
คนที่ทำงานอยู่กับกระบวนการทุกวันรู้ว่า งานจริงมีข้อยกเว้นตรงไหน ข้อมูลใดมักไม่ครบ อุปกรณ์ใดใช้งานยาก และการเปลี่ยนแปลงใดจะสร้างผลกระทบที่ผู้ออกแบบมองไม่เห็น
การให้คนหน้างานมีส่วนร่วมไม่ได้หมายความว่าองค์กรต้องทำตามทุกความเห็น แต่หมายความว่าการออกแบบต้องได้รับการทดสอบกับความจริง ก่อนจะถูกกำหนดให้เป็นมาตรฐาน
เมื่อคนมีส่วนร่วมในการเห็นปัญหา ทดลองทางเลือก และปรับวิธีทำงาน พวกเขาจะเข้าใจเหตุผลของระบบใหม่ เห็นข้อจำกัดก่อนใช้งานจริง และช่วยให้องค์กรเปลี่ยนผ่านได้โดยไม่ต้องพึ่งคำสั่งจากบนลงล่างเพียงอย่างเดียว
ประสิทธิภาพที่ดี ต้องไม่เกิดจากการผลักภาระไปให้คนที่มีอำนาจน้อยกว่า
ความรับผิดชอบ (responsibility) ในการออกแบบระบบ ไม่ได้จบที่การทำให้ตัวเลขต้นทุน ผลผลิต หรือเวลานำดีขึ้น
เราต้องถามด้วยว่า ผลลัพธ์เหล่านั้นเกิดจากการเปลี่ยนเงื่อนไขของระบบจริง หรือเกิดจากการให้คนทำ OT ต่อเนื่อง ให้หัวหน้างานแก้ทุกเรื่องเอง ให้พนักงานต้องจำข้อมูลมากเกินไป หรือให้ซัพพลายเออร์และผู้รับเหมารับความเสี่ยงแทนองค์กร
หากผลลัพธ์ดีขึ้นเพราะใครบางคนต้องแบกภาระมากขึ้น ระบบอาจดูมีประสิทธิภาพในระยะสั้น แต่ยังไม่ได้ถูกออกแบบอย่างรับผิดชอบ
การออกแบบที่ดีต้องมองเห็นต้นทุนที่ตัวเลขทั่วไปไม่เห็น: ความเหนื่อยล้า ความเสี่ยง ความไม่เป็นธรรม ความปลอดภัย และความสามารถของคนที่จะทำงานได้ดีในระยะยาว
สิ่งที่ผู้นำต้องตัดสินใจ
เมื่อออกแบบหรือปรับปรุงระบบ ผู้นำควรถามว่า
-
ความสามารถสำคัญใดที่องค์กรต้องปกป้อง แม้เกิดเหตุขัดข้อง
-
จุดใดเป็น single point of failure และทางเลือกใดช่วยลดผลกระทบได้อย่างคุ้มค่า
-
ระบบมีสัญญาณ ทางเลือก และสิทธิ์ตัดสินใจพอจะปรับตัวเมื่อแผนเดิมใช้ไม่ได้หรือไม่
-
AI และเทคโนโลยีที่นำมาใช้ช่วยให้คนตัดสินใจดีขึ้น หรือกำลังเร่งความสับสนเดิม
-
คนที่ต้องอยู่กับระบบทุกวันได้มีส่วนร่วมในการออกแบบและทดสอบจริงหรือไม่
-
ผลลัพธ์ที่ดีขึ้นเกิดจากระบบที่ดีขึ้น หรือเกิดจากการที่ใครบางคนต้องทำงานหนักขึ้นโดยไม่มีใครนับ
ระบบที่ดีไม่ได้ถูกออกแบบเพื่อรีดผลลัพธ์ให้มากที่สุดในวันนี้
มันถูกออกแบบเพื่อให้คนและองค์กรสร้างผลลัพธ์ที่ดีได้ต่อเนื่อง แม้ในวันที่โลกจริงไม่เป็นไปตามแผน