ความผันแปรเป็นส่วนหนึ่งของงานจริง Buffer ที่ดีจึงไม่ใช่การสำรองทุกอย่าง แต่คือการปกป้องสิ่งที่องค์กรยอมเสียไม่ได้
ฝ่ายวางแผนของบริษัทหนึ่งจัดทำแผนผลิตอย่างละเอียดทุกเดือน ทุกเครื่องจักรถูกจัดตารางเต็มกำลัง วัตถุดิบถูกสั่งให้มาถึงพอดีกับวันที่ต้องใช้ และทีมงานได้รับเป้าหมายให้ทำตามแผนอย่างเคร่งครัด
ในวันแรกของเดือน ทุกอย่างดูเป็นไปตามแผน
แต่ในสัปดาห์ที่สอง ลูกค้ารายสำคัญขอเลื่อนคำสั่งซื้อ วัตถุดิบรายการหนึ่งมาช้ากว่ากำหนด เครื่องจักรเครื่องหนึ่งหยุดกะทันหัน และพนักงานที่มีทักษะเฉพาะลาป่วย
แผนที่ถูกออกแบบมาอย่างดีจึงเริ่มใช้ไม่ได้
ทีมตอบสนองด้วยการเปลี่ยนตารางทุกวัน ทำ OT ขอให้บางคนทำงานแทนกัน และเร่งสั่งวัตถุดิบเพิ่ม งานบางส่วนยังส่งทัน แต่คนในระบบเริ่มเหนื่อย แผนเริ่มไม่น่าเชื่อถือ และปัญหาเดิมกลับมาในเดือนถัดไป
ความล้มเหลวไม่ได้เกิดจากทีมวางแผนขาดความสามารถ แต่เกิดจากแผนถูกสร้างขึ้นบนสมมติฐานว่าโลกจริงจะนิ่งกว่าที่เป็นอยู่ ความไม่แน่นอน (uncertainty) ไม่ได้เป็นข้อยกเว้นของเดือนนั้น แต่เป็นเงื่อนไขปกติที่แผนทุกฉบับต้องรองรับ
ความผันแปรไม่ใช่ข้อยกเว้นของการทำงาน
ความผันแปร (variation) คือความแตกต่างที่เกิดขึ้นในงานจริง แม้เราพยายามทำสิ่งเดิมให้เหมือนเดิมที่สุด เช่น เวลาที่ใช้ผลิตไม่เท่ากันทุกครั้ง คุณสมบัติของวัตถุดิบแตกต่างกันเล็กน้อย ความต้องการของลูกค้าเปลี่ยนไป หรือเวลาซ่อมเครื่องจักรไม่แน่นอน
ความผันแปรบางส่วนเป็นเรื่องปกติของระบบ ไม่อาจกำจัดได้ทั้งหมด เช่น ความต้องการที่ไม่เคยตรงกับตัวเลขคาดการณ์พอดี หรือเวลาที่คนแต่ละคนใช้ในการทำงานซึ่งย่อมแตกต่างกันบ้าง
แต่ความผันแปรบางส่วนเป็นสัญญาณว่าเกิดเหตุผิดปกติ เช่น เครื่องจักรที่เคยเดินนิ่งเริ่มหยุดบ่อย วัตถุดิบล็อตหนึ่งมีคุณสมบัติเปลี่ยนไปมาก หรืออัตราของเสียเพิ่มขึ้นอย่างชัดเจน
การจัดการความผันแปรที่ดีจึงเริ่มจากการแยกให้ออกว่า อะไรคือความแกว่งตามธรรมชาติที่ระบบต้องออกแบบให้รับได้ และอะไรคือความผิดปกติที่ต้องค้นหาสาเหตุและแก้ไข
หากองค์กรตอบสนองต่อความแกว่งเล็กน้อยทุกครั้งด้วยการเปลี่ยนแผน ระบบจะยิ่งไม่นิ่ง เพราะคนต้องปรับตัวกับคำสั่งใหม่ตลอดเวลา แต่หากองค์กรเพิกเฉยต่อสัญญาณผิดปกติที่สำคัญ ปัญหาก็จะสะสมจนแก้ยากกว่าเดิม
ความสามารถของผู้นำจึงไม่ได้อยู่ที่การทำให้ทุกอย่างไม่เปลี่ยน แต่คือการรู้ว่าอะไรควรปล่อยให้ระบบรับได้ และอะไรควรหยุดเพื่อเรียนรู้ทันที
ความผันแปรที่ระบบสร้างเอง กับความผิดปกติเฉพาะครั้ง ต้องแก้คนละวิธี
เมื่อเห็นตัวเลขที่ไม่เป็นไปตามเป้า คำถามแรกไม่ควรเป็นว่าใครทำ แต่ควรเป็นว่านี่คือความผันแปรแบบใด
ความผันแปรที่เกิดจากเงื่อนไขของระบบเอง common cause คือความแตกต่างที่เกิดขึ้นทุกวันโดยไม่มีเหตุพิเศษ เช่น เครื่องจักรที่มีความคลาดเคลื่อนตามอายุการใช้งาน วิธีทำงานที่แต่ละคนตีความต่างกันเล็กน้อย หรือวัตถุดิบที่คุณสมบัติแกว่งอยู่ในช่วงที่ยอมรับได้
ส่วนความผันแปรจากเหตุเฉพาะครั้ง special cause คือสิ่งที่ไม่ได้เป็นส่วนหนึ่งของระบบเดิม เช่น ชิ้นส่วนเครื่องจักรเสีย วัตถุดิบล็อตหนึ่งผิดสเปก หรือการตั้งค่าเครื่องผิดในกะใดกะหนึ่ง
ความแตกต่างนี้สำคัญ เพราะมันบอกว่าใครควรเป็นคนแก้ ความผิดปกติเฉพาะครั้งแก้ได้ที่หน้างานและควรแก้ทันที ส่วนความผันแปรของระบบไม่มีทางแก้ได้ด้วยการกำชับคนหน้างาน เพราะมันคือผลของเงื่อนไขที่ผู้ออกแบบระบบเป็นคนกำหนดไว้แล้ว
ความผิดพลาดที่พบบ่อยที่สุดคือการสลับสองอย่างนี้ องค์กรที่ตามหาผู้รับผิดชอบทุกครั้งที่ตัวเลขแกว่งตามปกติ จะสอนให้คนเก่งขึ้นในการอธิบายตัวเลข ไม่ใช่การปรับปรุงงาน ส่วนองค์กรที่รับความผิดปกติจริงไว้ว่าเป็นเรื่องปกติของสายนี้ จะไม่มีใครไปตามหาสาเหตุอีกเลย
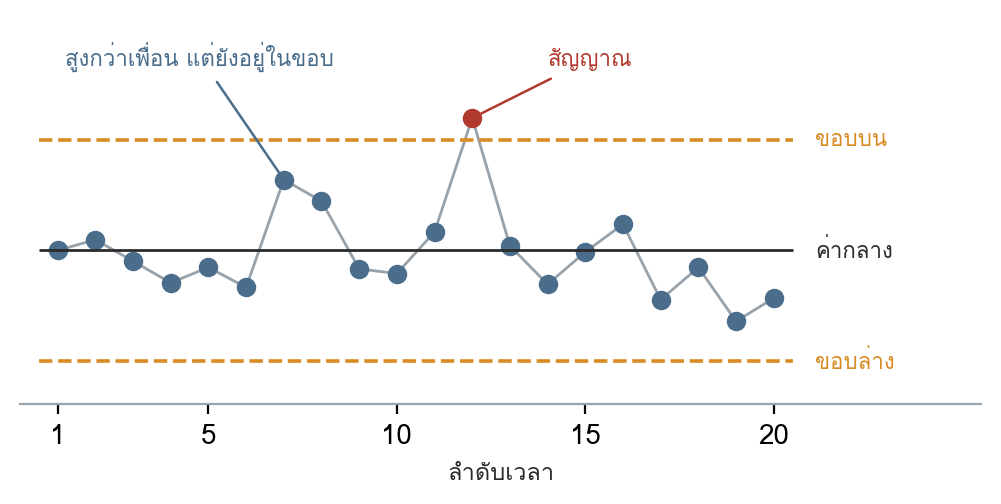
วิธีแยกสองอย่างนี้โดยไม่ต้องเดา คือบันทึกผลที่วัดได้เรียงตามเวลา แล้วตกลงร่วมกันว่าช่วงใดคือความผันแปรปกติของกระบวนการ แผนภูมิควบคุม control chart ทำหน้าที่นี้ จุดที่หลุดออกนอกช่วง หรือเรียงตัวเป็นรูปแบบที่ไม่น่าเกิดจากความบังเอิญ คือสัญญาณของเหตุเฉพาะครั้ง ส่วนการแกว่งขึ้นลงอยู่ภายในช่วง คือความผันแปรของระบบเอง
องค์กรไม่จำเป็นต้องใช้สถิติชั้นสูงเพื่อเริ่มต้น เพียงพล็อตค่าตามเวลาแล้วตกลงกันว่าอะไรคือช่วงปกติ ก็เพียงพอจะเปลี่ยนบทสนทนาประจำวัน จากการหาคนผิด ไปสู่คำถามว่าอะไรเปลี่ยนไป
EXHIBIT 10.1 · Control Chart
ที่มา: แผนภูมิควบคุม · Walter A. Shewhart
รูปที่ 43 — ยี่สิบจุดเรียงตามเวลา และจุดที่หลุดออกนอกขอบ
- Common Cause — จุดที่แกว่งอยู่ในขอบ แก้ด้วยการเปลี่ยนกระบวนการ ไม่ใช่การไล่รายวัน
- Special Cause — จุดที่หลุดขอบ หรือเรียงเป็นรูปแบบที่ไม่ควรเกิดจากความบังเอิญ แก้เฉพาะครั้ง
- ที่มาของขอบ — คำนวณจากพฤติกรรมของกระบวนการเอง ไม่ใช่จากสเปกที่ลูกค้ากำหนด
ให้ดูอะไร บางจุดที่สูงกว่าเพื่อน ยังอยู่ในขอบและไม่ใช่สัญญาณ
อ่านผิดบ่อย เอาสเปกของลูกค้ามาเป็นขอบ ซึ่งทำให้ระบบดูปกติทั้งที่ไม่นิ่ง
ความผันแปรเพียงเล็กน้อย สร้างคิวยาวได้มากกว่าที่คิด
เมื่อระบบมีงานเข้ามาใกล้เต็มกำลัง ความผันแปรเพียงเล็กน้อยก็สามารถสร้างผลกระทบที่ใหญ่กว่าตัวมันเอง
หากเครื่องจักรใช้เวลาทำงานต่อชิ้นไม่เท่ากันเล็กน้อย หรือมีงานด่วนเข้ามาเป็นครั้งคราว ระบบอาจรับมือได้ง่ายเมื่อยังมีกำลังว่างอยู่บ้าง แต่เมื่อทุกเครื่อง ทุกคน และทุกตารางถูกใช้จนเกือบเต็ม ความแตกต่างเล็กน้อยจะไม่มีที่ให้ซึมซับ
งานเริ่มต่อคิว งานที่มาถึงช้ากว่ากำหนดเพียงเล็กน้อยทำให้ขั้นตอนถัดไปต้องรอ การรอนั้นทำให้งานอื่นเริ่มช้า และความล่าช้าก็ค่อย ๆ ส่งต่อไปตลอดทั้งระบบ
นี่คือเหตุผลที่แผนที่ดูมีประสิทธิภาพมากบนกระดาษ อาจกลับเปราะบางมากในโลกจริง
การรับงานเกินกำลัง การใช้ทรัพยากรเต็มร้อย หรือการเปลี่ยนแผนบ่อย จึงไม่เพียงสร้างปัญหาเฉพาะจุด แต่ทำให้ระบบไม่มีพื้นที่พอจะรับความผันแปรตามปกติของงาน
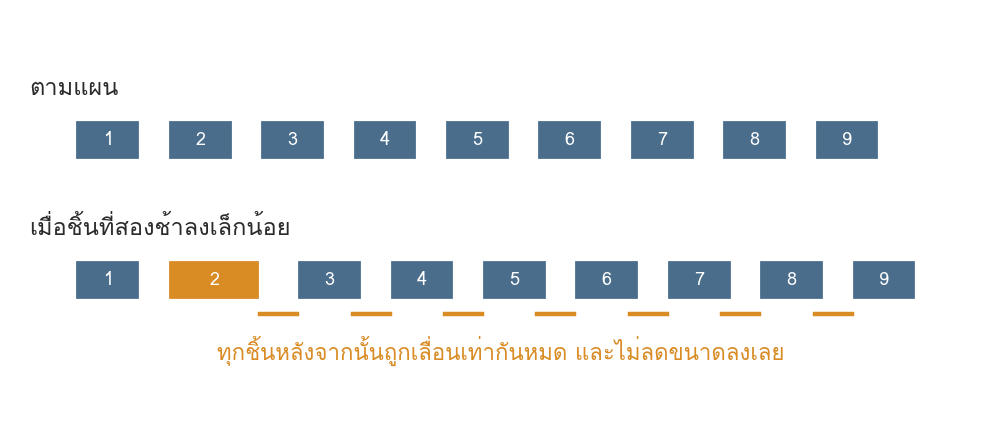
EXHIBIT 10.2 · ผลต่อเนื่องของความล่าช้าครั้งเดียว
ที่มา: ผลจากทฤษฎีคิว
รูปที่ 44 — งานเก้าชิ้นเดียวกัน เมื่อชิ้นที่สองช้าลงเล็กน้อย
- ทำไมจึงสะสม — เมื่อไม่มีเวลาว่างระหว่างงาน ความล่าช้าจะไม่มีที่ให้หายไป
- อะไรทำให้แย่ลง — การใช้กำลังใกล้เต็ม ขนาดล็อตใหญ่ และเวลาทำงานที่ไม่แน่นอน
- อะไรช่วยได้ — ช่องว่างที่ตั้งใจเหลือไว้ และการลดความผันแปรของเวลาทำงานเอง
ให้ดูอะไร งานทุกชิ้นหลังจากนั้นถูกเลื่อนเท่ากันหมด และไม่ลดขนาดลงเลย
อ่านผิดบ่อย ประเมินผลกระทบจากความยาวของการหยุด แทนที่จะดูว่ามีงานรออยู่ข้างหลังกี่ชิ้น
แผนคือสมมติฐาน ไม่ใช่ความจริงล่วงหน้า
ทุกแผนสร้างขึ้นจากข้อมูลที่ยังไม่เกิดขึ้นจริง ไม่ว่าจะเป็นยอดขาย การคาดการณ์ความต้องการ เวลาส่งมอบวัตถุดิบ หรือกำลังการผลิตของเครื่องจักร
นี่ไม่ได้ทำให้การวางแผนไม่มีประโยชน์ ตรงกันข้าม แผนทำให้องค์กรเห็นสิ่งที่ต้องเตรียมและสิ่งที่อาจขัดกัน แต่เราควรมองแผนเป็นสมมติฐานที่ต้องติดตามและปรับตามหลักฐาน ไม่ใช่สัญญาที่โลกจริงต้องทำตาม
เมื่อความต้องการเปลี่ยน องค์กรไม่ควรตอบสนองด้วยการเขียนแผนใหม่ทุกครั้งทันที ควรมีเกณฑ์ชัดว่า ความเปลี่ยนแปลงระดับใดต้องปรับแผน ใครมีสิทธิ์ปรับ และการปรับนั้นจะกระทบงานใดบ้าง
การมีเกณฑ์เช่นนี้ช่วยให้ระบบไม่แกว่งตามความเร่งด่วนของแต่ละวัน และทำให้คนหน้างานรู้ว่าคำสั่งใดคือการเปลี่ยนแปลงที่ต้องทำจริง ไม่ใช่เพียงการขอให้ช่วยกันแก้เฉพาะหน้า
Buffer ไม่ได้มีไว้ซ่อนปัญหา แต่มีไว้ปกป้องสิ่งสำคัญ
กันชน (buffer) คือทรัพยากรที่องค์กรตั้งใจสำรองไว้ เพื่อดูดซับความผันแปรและป้องกันไม่ให้ความผิดปกติเล็กน้อยลุกลามไปทำลายผลลัพธ์สำคัญ
Buffer อาจอยู่ในรูปของเวลา สินค้าคงคลัง กำลังการผลิต พนักงานที่ทดแทนกันได้ อะไหล่สำคัญ หรือทางเลือกของซัพพลายเออร์
การมี Buffer ไม่ได้แปลว่าองค์กรขาดประสิทธิภาพเสมอไป สิ่งที่สำคัญคือ Buffer ต้องมีเหตุผลชัดเจนว่ากำลังปกป้องอะไร และกำลังรับความเสี่ยงชนิดใด
ตัวอย่างเช่น อะไหล่ของเครื่องจักรที่หากหยุดแล้วทำให้ทั้งระบบหยุด อาจควรมีสำรอง แม้จะใช้ไม่บ่อย วัตถุดิบที่ใช้กับสินค้าหลักและมีเวลานำยาว อาจควรมีสต็อกกันชน ขณะที่สินค้าที่หาทดแทนได้ง่ายและไม่มีผลต่อการส่งมอบ อาจไม่จำเป็นต้องสำรองมาก
Buffer ที่ดีจึงเป็นการเลือก ไม่ใช่การกักตุนทุกอย่าง
ในขณะเดียวกัน Buffer ไม่ควรถูกใช้เพื่อซ่อนปัญหา หากต้องเก็บสต็อกจำนวนมากเพราะกระบวนการผลิตไม่นิ่ง หรือหากต้องมีคนสำรองหลายคนเพราะไม่มีมาตรฐานงานที่ทำให้ใครทดแทนกันได้ องค์กรควรใช้ Buffer เพื่อปกป้องการส่งมอบในระยะสั้น แต่ต้องแก้สาเหตุของความเปราะบางควบคู่กันไป
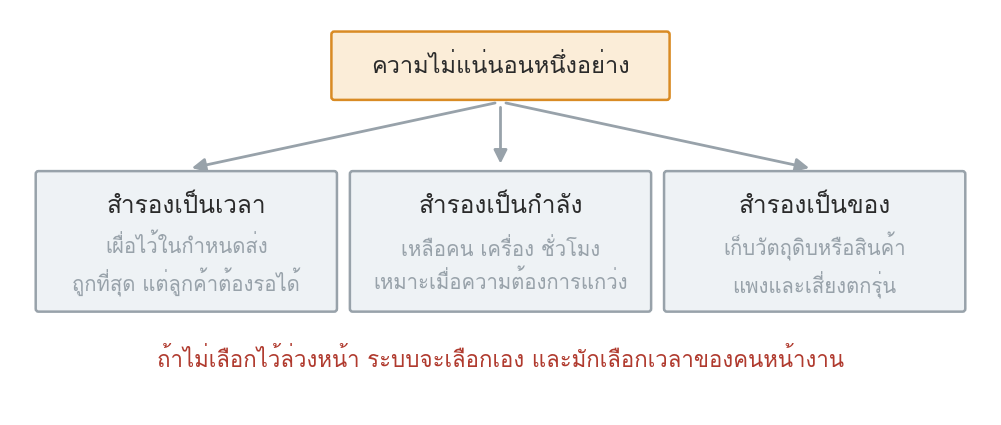
EXHIBIT 10.3 · สามอย่างที่สำรองได้
ที่มา: Time · Capacity · Inventory Buffer
รูปที่ 47 — ความไม่แน่นอนหนึ่งอย่าง กับสามทางที่รับไว้ได้
- สำรองเป็นเวลา — เผื่อเวลาไว้ในกำหนดส่ง ถูกที่สุด แต่ใช้ได้เมื่อลูกค้ารอได้
- สำรองเป็นกำลัง — เหลือคน เครื่อง หรือชั่วโมงไว้ เหมาะเมื่อความต้องการแกว่ง
- สำรองเป็นของ — เก็บวัตถุดิบหรือสินค้าไว้ เหมาะเมื่อของหายาก แต่แพงและเสี่ยงตกรุ่น
ให้ดูอะไร ทั้งสามกล่องรับแรงกระแทกเดียวกัน แต่จ่ายด้วยของคนละอย่าง
อ่านผิดบ่อย ใช้สต็อกเป็นคำตอบเดียวเสมอ เพราะเป็นอย่างเดียวที่มองเห็นและสั่งได้ง่าย
จากการดับไฟ สู่ระบบที่ฟื้นตัวได้
ความสามารถในการรับแรงกระแทก ฟื้นตัว และเรียนรู้จากสิ่งที่เกิดขึ้น เรียกว่า ความยืดหยุ่นของระบบ (resilience)
องค์กรที่มี resilience ไม่ใช่องค์กรที่ไม่เคยมีเหตุขัดข้อง แต่เป็นองค์กรที่เมื่อเกิดเหตุแล้ว รู้ว่าอะไรสำคัญที่สุด เห็นปัญหาเร็ว มีทางเลือกที่เตรียมไว้ และกลับมาส่งมอบได้โดยไม่ต้องพึ่งการเสียสละของคนกลุ่มเดิมทุกครั้ง
การดับไฟเก่งอาจทำให้องค์กรผ่านเหตุการณ์หนึ่งไปได้ แต่ถ้าทุกครั้งต้องใช้ OT ต้องโทรหาคนเดิม ต้องแก้แผนแบบไม่มีหลัก หรือปล่อยให้คนหน้างานแบกภาระโดยไม่มีการเปลี่ยนแปลงระบบ องค์กรยังไม่ได้มี resilience
Resilience เกิดจากสิ่งที่องค์กรทำก่อนเกิดปัญหา: ระบุว่าสิ่งใดหยุดไม่ได้ สร้าง Buffer ในจุดที่เหมาะสม ฝึกให้คนทดแทนกันได้ ทำให้ข้อมูลสำคัญมองเห็น และกำหนดสิทธิ์ตัดสินใจเมื่อแผนเดิมใช้ไม่ได้
หลังเหตุการณ์ผ่านไป ต้องมีคำถามต่อเสมอว่า ระบบเรียนรู้อะไร และอะไรจะเปลี่ยนเพื่อให้ครั้งหน้าไม่ต้องใช้ความพยายามมากเท่าเดิม
สิ่งที่ผู้นำต้องตัดสินใจ
เมื่อวางแผนหรือรับมือกับความไม่แน่นอน ผู้นำควรถามว่า
-
ความผันแปรใดเป็นเรื่องปกติที่ระบบควรรับได้ และความผันแปรใดเป็นสัญญาณผิดปกติที่ต้องแก้
-
แผนปัจจุบันมีพื้นที่พอให้ระบบรับงานด่วน การหยุดเครื่อง หรือความล่าช้าโดยไม่ทำให้ทุกอย่างเสียไปพร้อมกันหรือไม่
-
Buffer ที่มีอยู่กำลังปกป้องผลลัพธ์สำคัญอะไร และมี Buffer ใดที่กำลังซ่อนปัญหาซึ่งควรแก้ที่ต้นเหตุ
-
เมื่อแผนใช้ไม่ได้ คนในระบบรู้หรือไม่ว่าอะไรต้องปกป้องก่อน ใครตัดสินใจได้ และมีทางเลือกใดบ้าง
-
หลังเหตุการณ์ผ่านไป องค์กรเปลี่ยนเงื่อนไขใด เพื่อให้ครั้งต่อไปฟื้นตัวได้ดีขึ้นจริง
องค์กรที่ดีไม่ใช่องค์กรที่คาดการณ์ทุกอย่างถูกต้อง
มันคือองค์กรที่ออกแบบตัวเองไว้ดีพอจะไม่พัง เมื่อโลกจริงไม่เป็นไปตามแผน